Liputan6.com, Jakarta - Permintaan terhadap kecerdasan buatan () di sejumlah industri kian meningkat. Semakin banyak orang dan perusahaan menggunakan AI untuk berbagai keperluan, mulai dari menulis kode hingga menganalisis dokumen.
Untuk memenuhi permintaan itu, perusahaan teknologi terus membangun pusat data. Setiap fasilitas baru membutuhkan lahan, biaya pembangunan dan operasional, serta pasokan listrik yang stabil.
Server di dalamnya menghasilkan panas, sehingga sistem pendingin bisa membutuhkan listrik tambahan. Di beberapa fasilitas, pendinginan juga memerlukan air.
Tim peneliti di The University of Texas at Austin ingin mengetahui seberapa banyak pekerjaan tambahan yang bisa ditangani sistem AI dengan perangkat keras yang sudah ada.
Agen AI dapat memecah satu permintaan menjadi serangkaian tugas yang lebih kecil. Ketika banyak permintaan masuk bersamaan, tugas bisa menumpuk di sejumlah prosesor, sementara prosesor lain masih memiliki kapasitas. Koordinasi yang lebih baik dapat membantu memanfaatkan kapasitas yang belum terpakai itu.
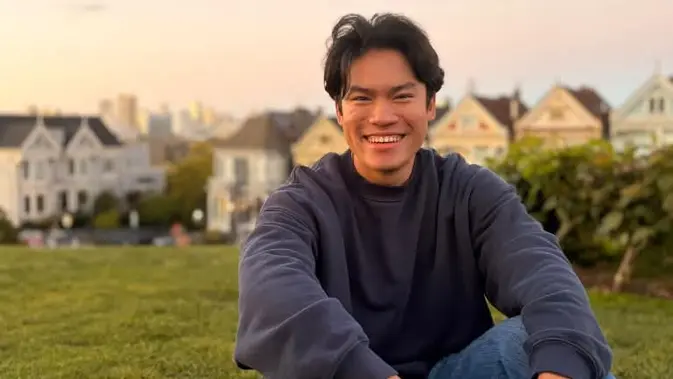
Bersama tim tersebut, Marco Laju, insinyur asal Indonesia yang kini bekerja di San Francisco, mengembangkan NALAR, sistem yang menentukan kapan dan di mana tugas-tugas tersebut dijalankan.
Dalam pengujian tim, beberapa alur kerja agen AI berjalan lebih dari tiga kali lebih cepat dengan sumber daya komputasi yang sama. Jika hasil serupa tercapai dalam penggunaan sehari-hari, operator pusat data bisa menangani lebih banyak permintaan sebelum perlu menambah server atau memperluas fasilitas.
“Seiring meningkatnya permintaan terhadap AI, kita perlu melihat seberapa banyak lagi pekerjaan yang bisa ditangani server yang sudah ada,” kata Marco dalam keterangannya, Rabu (18/11/2026).
Lewat NALAR, ia menambahkan, ingin mengetahui seberapa besar kapasitas yang bisa dimanfaatkan dengan mengubah cara perangkat lunak menjadwalkan tugas.
Mengapa Agen AI Sering Lambat dan Boros Memori?
Ketika pengguna meminta AI menyusun laporan yang kompleks, kata Marco, sistem memecah permintaan itu menjadi ratusan tugas kecil yang saling berkaitan. Sebagian bisa berjalan bersamaan, sementara yang lain harus menunggu langkah sebelumnya selesai.
“Ketika ribuan pengguna mengakses sistem secara bersamaan, tugas sering menumpuk di satu bagian sistem komputasi, sementara bagian lain menganggur,” kata Marco.
Keterbatasan memori GPU memperparah masalah ini. Sebagian memori terpakai untuk menyimpan data pemrosesan sementara. Akibatnya, waktu tunggu bertambah dan kapasitas komputasi terbuang.
Cara NALAR Membuat Pemrosesan Lebih Efisien
Marco bekerja bersama Dr. Saurabh Agarwal, peneliti di UT Austin (Research Fellow) sekaligus salah satu penulis studi NALAR, dan anggota tim riset lainnya untuk membangun sistem yang mengatur kapan dan di mana tugas agen AI dijalankan.
Sistem ini melacak ketergantungan antartugas, sehingga bisa mengetahui tugas mana yang siap dijalankan dan mana yang masih tertahan dalam antrean.
Salah satu inovasinya adalah memindahkan tugas yang sedang mengantre, beserta “catatan” atau data pemrosesannya, ke bagian sistem yang memiliki lebih banyak kapasitas.
NALAR melakukan pemindahan ketika perkiraan waktu yang bisa dihemat dengan keluar dari antrean lebih besar daripada waktu yang dibutuhkan untuk memindahkan data.
“Marco dan saya harus memutuskan kapan sebuah tugas layak dipindahkan. Kalau memindahkan datanya memakan waktu lebih lama daripada menunggu giliran, tugas itu tetap di tempatnya,” kata Agarwal.
NALAR juga bisa mengeluarkan sementara data yang sedang tidak digunakan dari memori GPU dan mengembalikannya saat dibutuhkan.
Dengan cara ini, NALAR membantu mengatasi antrean panjang, pembagian beban komputasi yang tidak merata, dan kapasitas memori yang terbuang.
Peningkatan Kinerja hingga 3,38 Kali
Pengujian tim peneliti menunjukkan peningkatan kinerja yang signifikan. Makalah NALAR versi revisi melaporkan bahwa alur kerja agen AI berjalan hingga 3,38 kali lebih cepat dibandingkan dengan sistem konvensional, dengan sumber daya komputasi yang sama.
Waktu respons, atau latensi, turun hingga 74 persen untuk permintaan dengan waktu tunggu yang panjang.
“Kami menggunakan sumber daya komputasi yang sama pada kedua sistem yang kami bandingkan. Dengan begitu, kami bisa melihat seberapa besar pengaruh perangkat lunaknya saja,” kata Agarwal.
“NALAR menunjukkan bahwa koordinasi yang lebih baik di tingkat perangkat lunak bisa meningkatkan kinerja. Ini membuka peluang untuk memanfaatkan infrastruktur yang sudah ada dengan lebih efektif,” Marco menimpakan.
Pengakuan dari Harvard dan Peneliti di Berbagai Negara
Riset ini kini masuk dalam daftar bacaan mata kuliah Modern AI Systems: Agents and System Optimizations di Harvard University.
Temuan Marco dan timnya juga telah dikutip dalam sejumlah makalah yang melibatkan peneliti dari Adobe Research dan Alibaba Cloud, serta akademisi dari University of Chicago dan University of Washington.
Di tengah pembangunan pusat data yang terus meningkat, karya lulusan ilmu komputer The University of Texas at Austin ini menunjukkan bagaimana koordinasi perangkat lunak yang lebih baik bisa membuat AI bekerja lebih efisien dengan perangkat keras yang sudah tersedia.